 EC2
 ECS
 EKS
 RDS
 Routeur · eu-west-3
Instances EC2
Arrêtées à la mise en veille, démarrées au réveil. Elles restent enregistrées dans leur target group.
Produit
Dormeto repose sur deux briques. Dans chaque compte et chaque région, un routeur met en veille et réveille vos workloads. Le manager les découvre, les intègre et les exploite dans toute votre organisation. Tout s'exécute dans vos comptes AWS.
Le routeur · un par compte et par région
Le routeur surveille le nombre de requêtes de chaque workload sur son équilibreur de charge. Le délai d'inactivité est de 15 minutes par défaut, contrôlé toutes les 5 minutes. Une fois passé, chaque règle qui transfère vers le target group du workload pointe sur le waker. Le routeur arrête ensuite les backends. Une requête reçue pendant cette bascule annule la mise en veille. La première vraie requête déclenche un seul réveil. Les requêtes sont mises en attente jusqu'à 60 secondes et redirigées dès que l'application répond. Sinon, elles reçoivent une page qui se recharge d'elle-même. Les clients d'API reçoivent une réponse JSON qui indique quand réessayer.
Les ressources taguées dormeto:workload derrière le target group du workload. L'intégration pose ce tag pour vous. Ou le Deployment ou StatefulSet Kubernetes dont ce target group dessert les
pods.
Arrêtées à la mise en veille, démarrées au réveil. Elles restent enregistrées dans leur target group.
Ramenés à zéro, leurs processus de scaling suspendus, puis rétablis à leur capacité d'origine. Avec un warm pool à l'état Stopped, le réveil redémarre des instances au lieu d'en lancer de nouvelles.
Fargate ou EC2 : le nombre de tâches souhaité passe à zéro et Application Auto Scaling est suspendu, jusqu'au réveil.
Les bases de données sont mises en veille avec leur application : arrêtées après elle, démarrées et prêtes avant elle. Une base qu'AWS redémarre au bout de sept jours est de nouveau arrêtée.
Deployments et StatefulSets derrière l'AWS Load Balancer Controller. Ils passent à zéro réplica, et un éventuel ScaledObject KEDA est mis en pause. Leurs réplicas reviennent au réveil. Dormeto ajoute son propre Ingress à votre IngressGroup et ne modifie jamais les vôtres.
Sur un nom d'hôte public, les scanners arrivent dans les minutes qui suivent l'émission d'un certificat. Réveiller le workload pour eux réduirait les économies à néant.
Les requêtes HEAD, les bots, les crawlers, les sondes de supervision et les scanners Internet reçoivent la page d'attente sans déclencher de réveil. Il en va de même des chemins que visent les scanners, comme /.env ou /wp-login.php.
Seul le script de la page d'attente peut réveiller le workload. Un scanner qui n'exécute pas JavaScript ne le réveille donc jamais. Les clients d'API et les scripts le réveillent avec l'en-tête x-dormeto-wake: 1.
Tant qu'un workload n'est pas actif, ses réveils et les requêtes qui ne l'ont pas réveillé sont comptés. Le tableau de bord les affiche sur 7 jours.
Délai entre la première requête et la première réponse de l'application, sur nos workloads
de test en eu-west-1.
| Workload | Temps de réveil |
|---|---|
| Service ECS sur Fargate (0,25 vCPU) | 29 à 52 s |
| Instance EC2 (t4g.nano) | 35 à 42 s |
| Groupe Auto Scaling avec un warm pool arrêté | 35 s |
| Service Fargate et PostgreSQL (db.t4g.micro) | 6 à 14 min |
Le temps de démarrage de votre application s'ajoute à ces durées. Pour les réveils longs, avec une base de données par exemple, les visiteurs voient la page qui se recharge d'elle-même.
Dormeto couvre chacune de vos règles par sa propre règle, placée juste avant elle avec les mêmes conditions. Votre règle reste telle quelle. Une règle qui agit avant son transfert, comme une connexion, reçoit elle-même le waker : les étapes de l'opération le signalent.
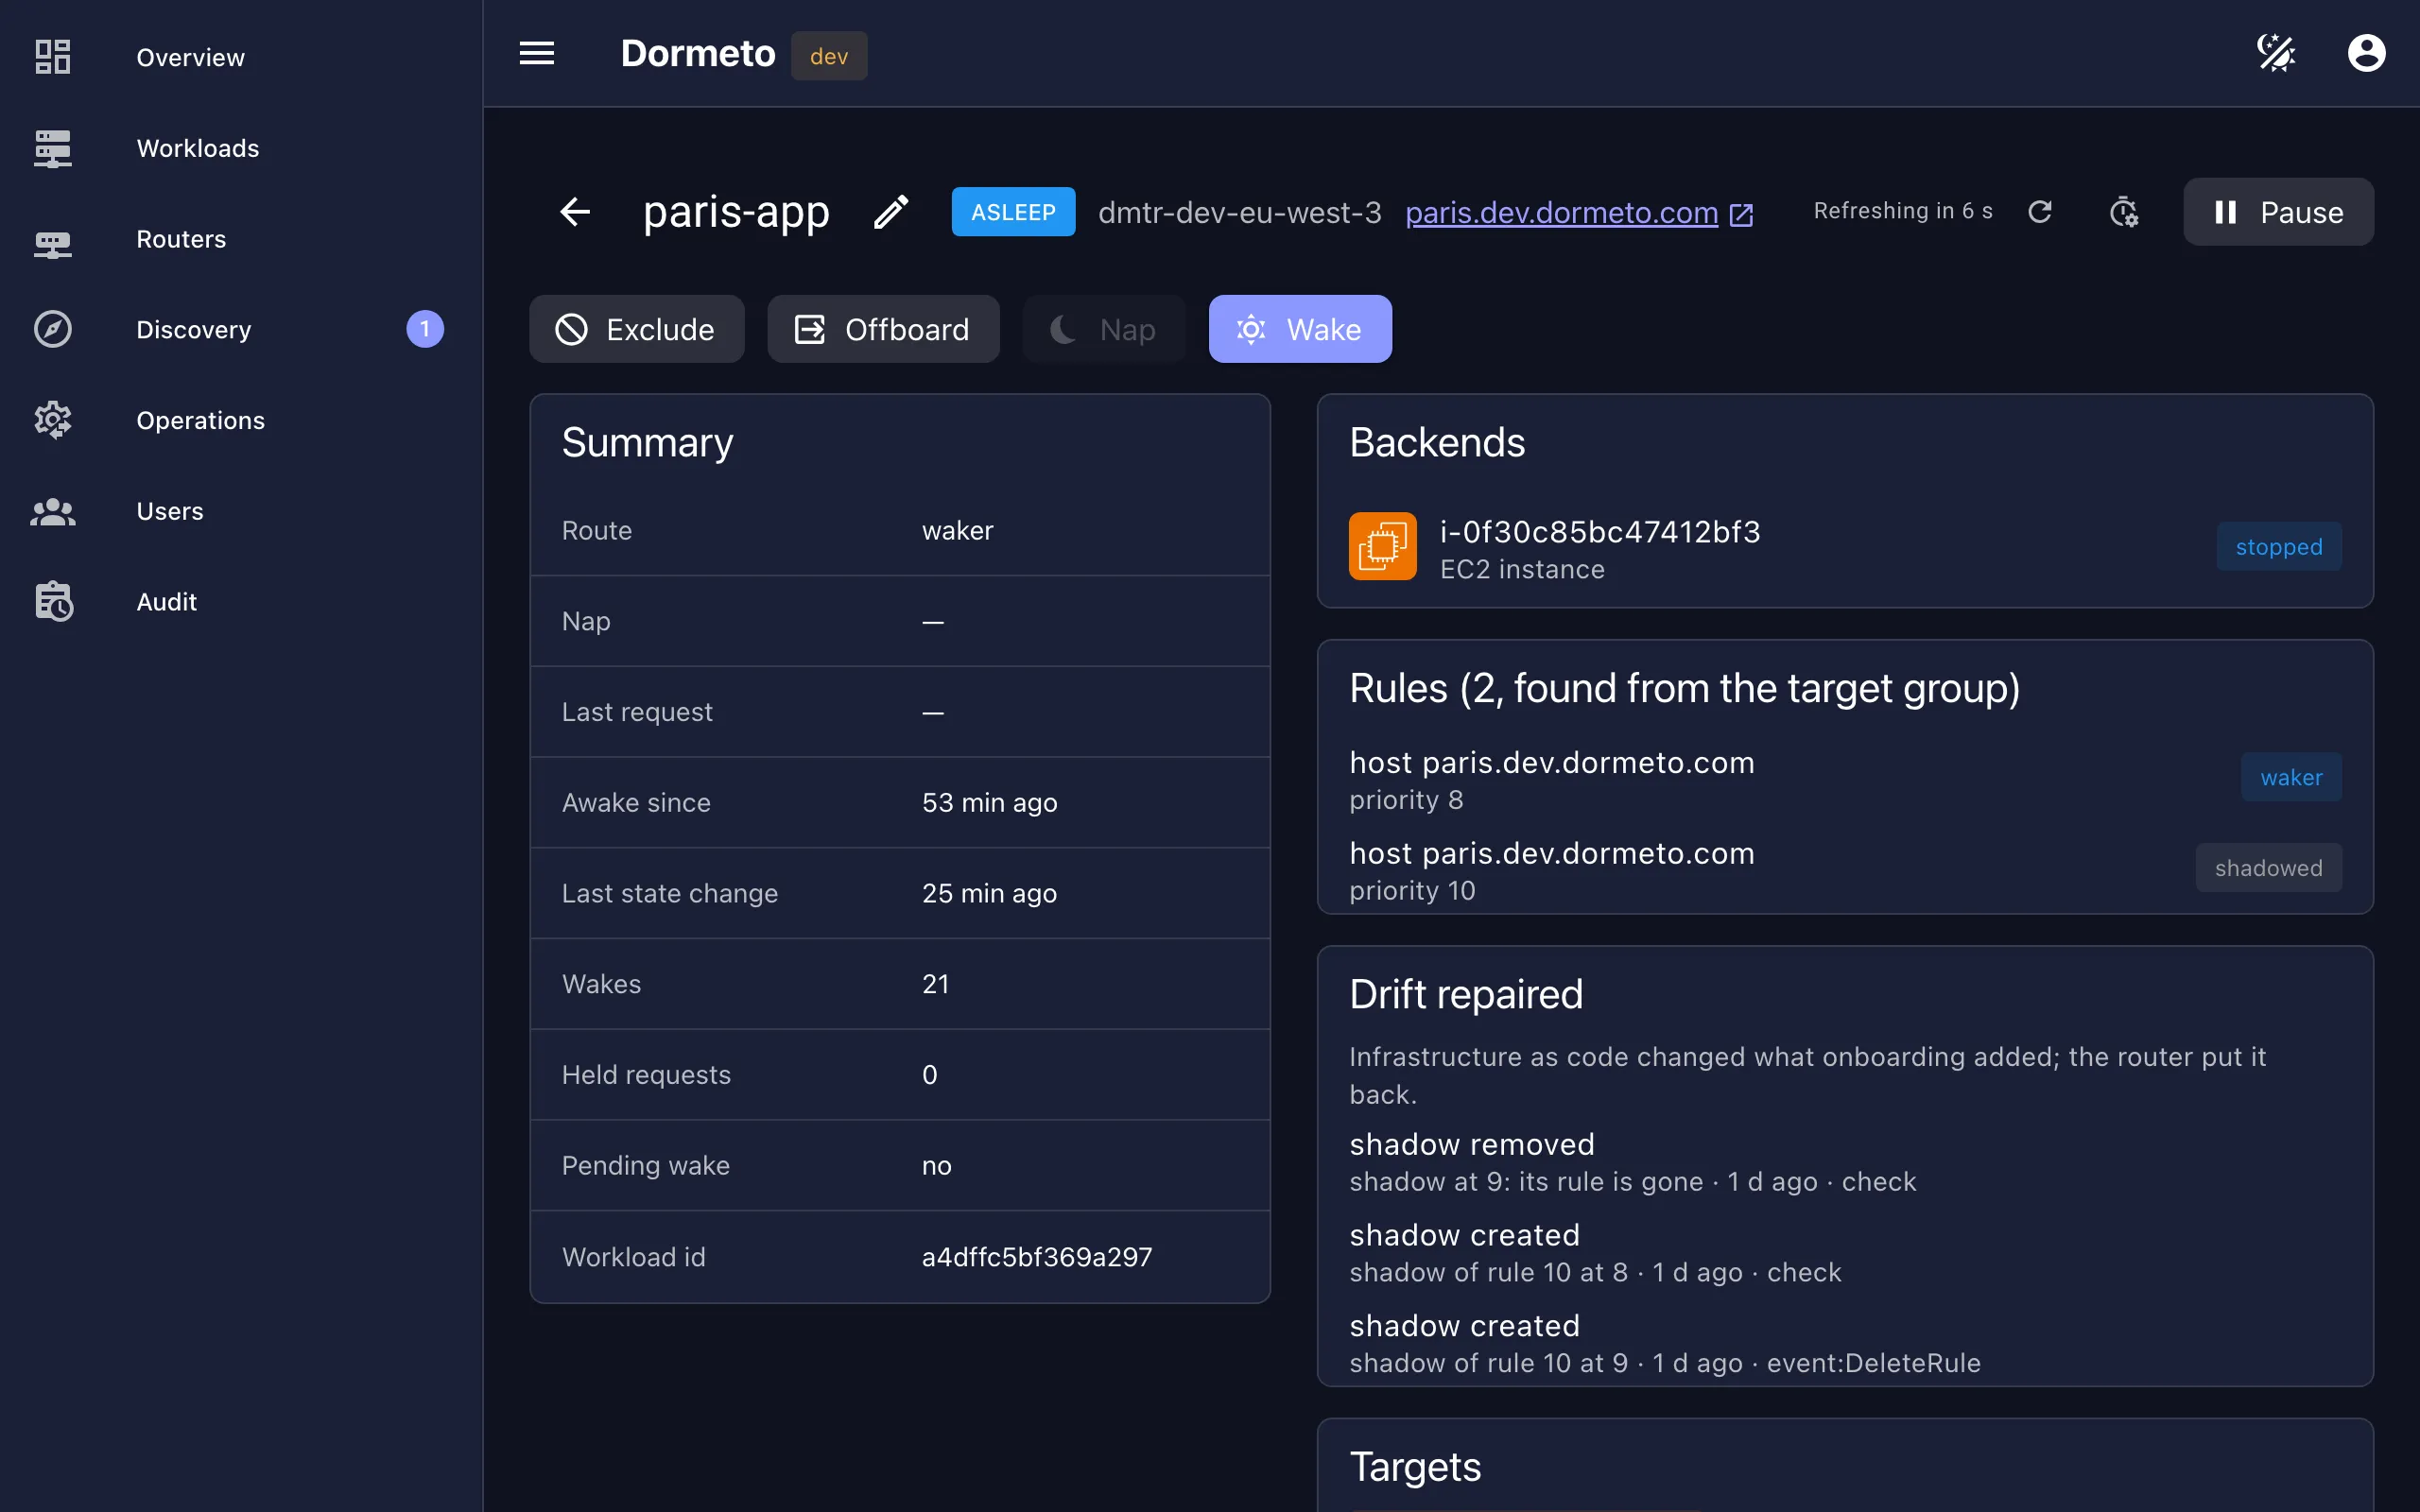
Si vos outils modifient ou suppriment ce que l'intégration a ajouté, les événements CloudTrail en informent le routeur. Il le rétablit en une minute environ dans nos tests. Chaque correction est consignée sur la page du workload. Quelques lignes de Terraform évitent que vos plans le retirent.
Vous pouvez mettre en pause un workload ou un routeur entier, avec un motif et, si besoin, une reprise automatique. Un workload en pause n'est jamais mis en veille. Les requêtes le réveillent toujours.
Le manager · un par organisation
Le manager s'exécute dans un compte de votre organisation. Il fournit un tableau de bord et une API. Il mène la découverte et les opérations dans vos autres comptes au moyen de rôles que vous créez.
Vue d'ensemble
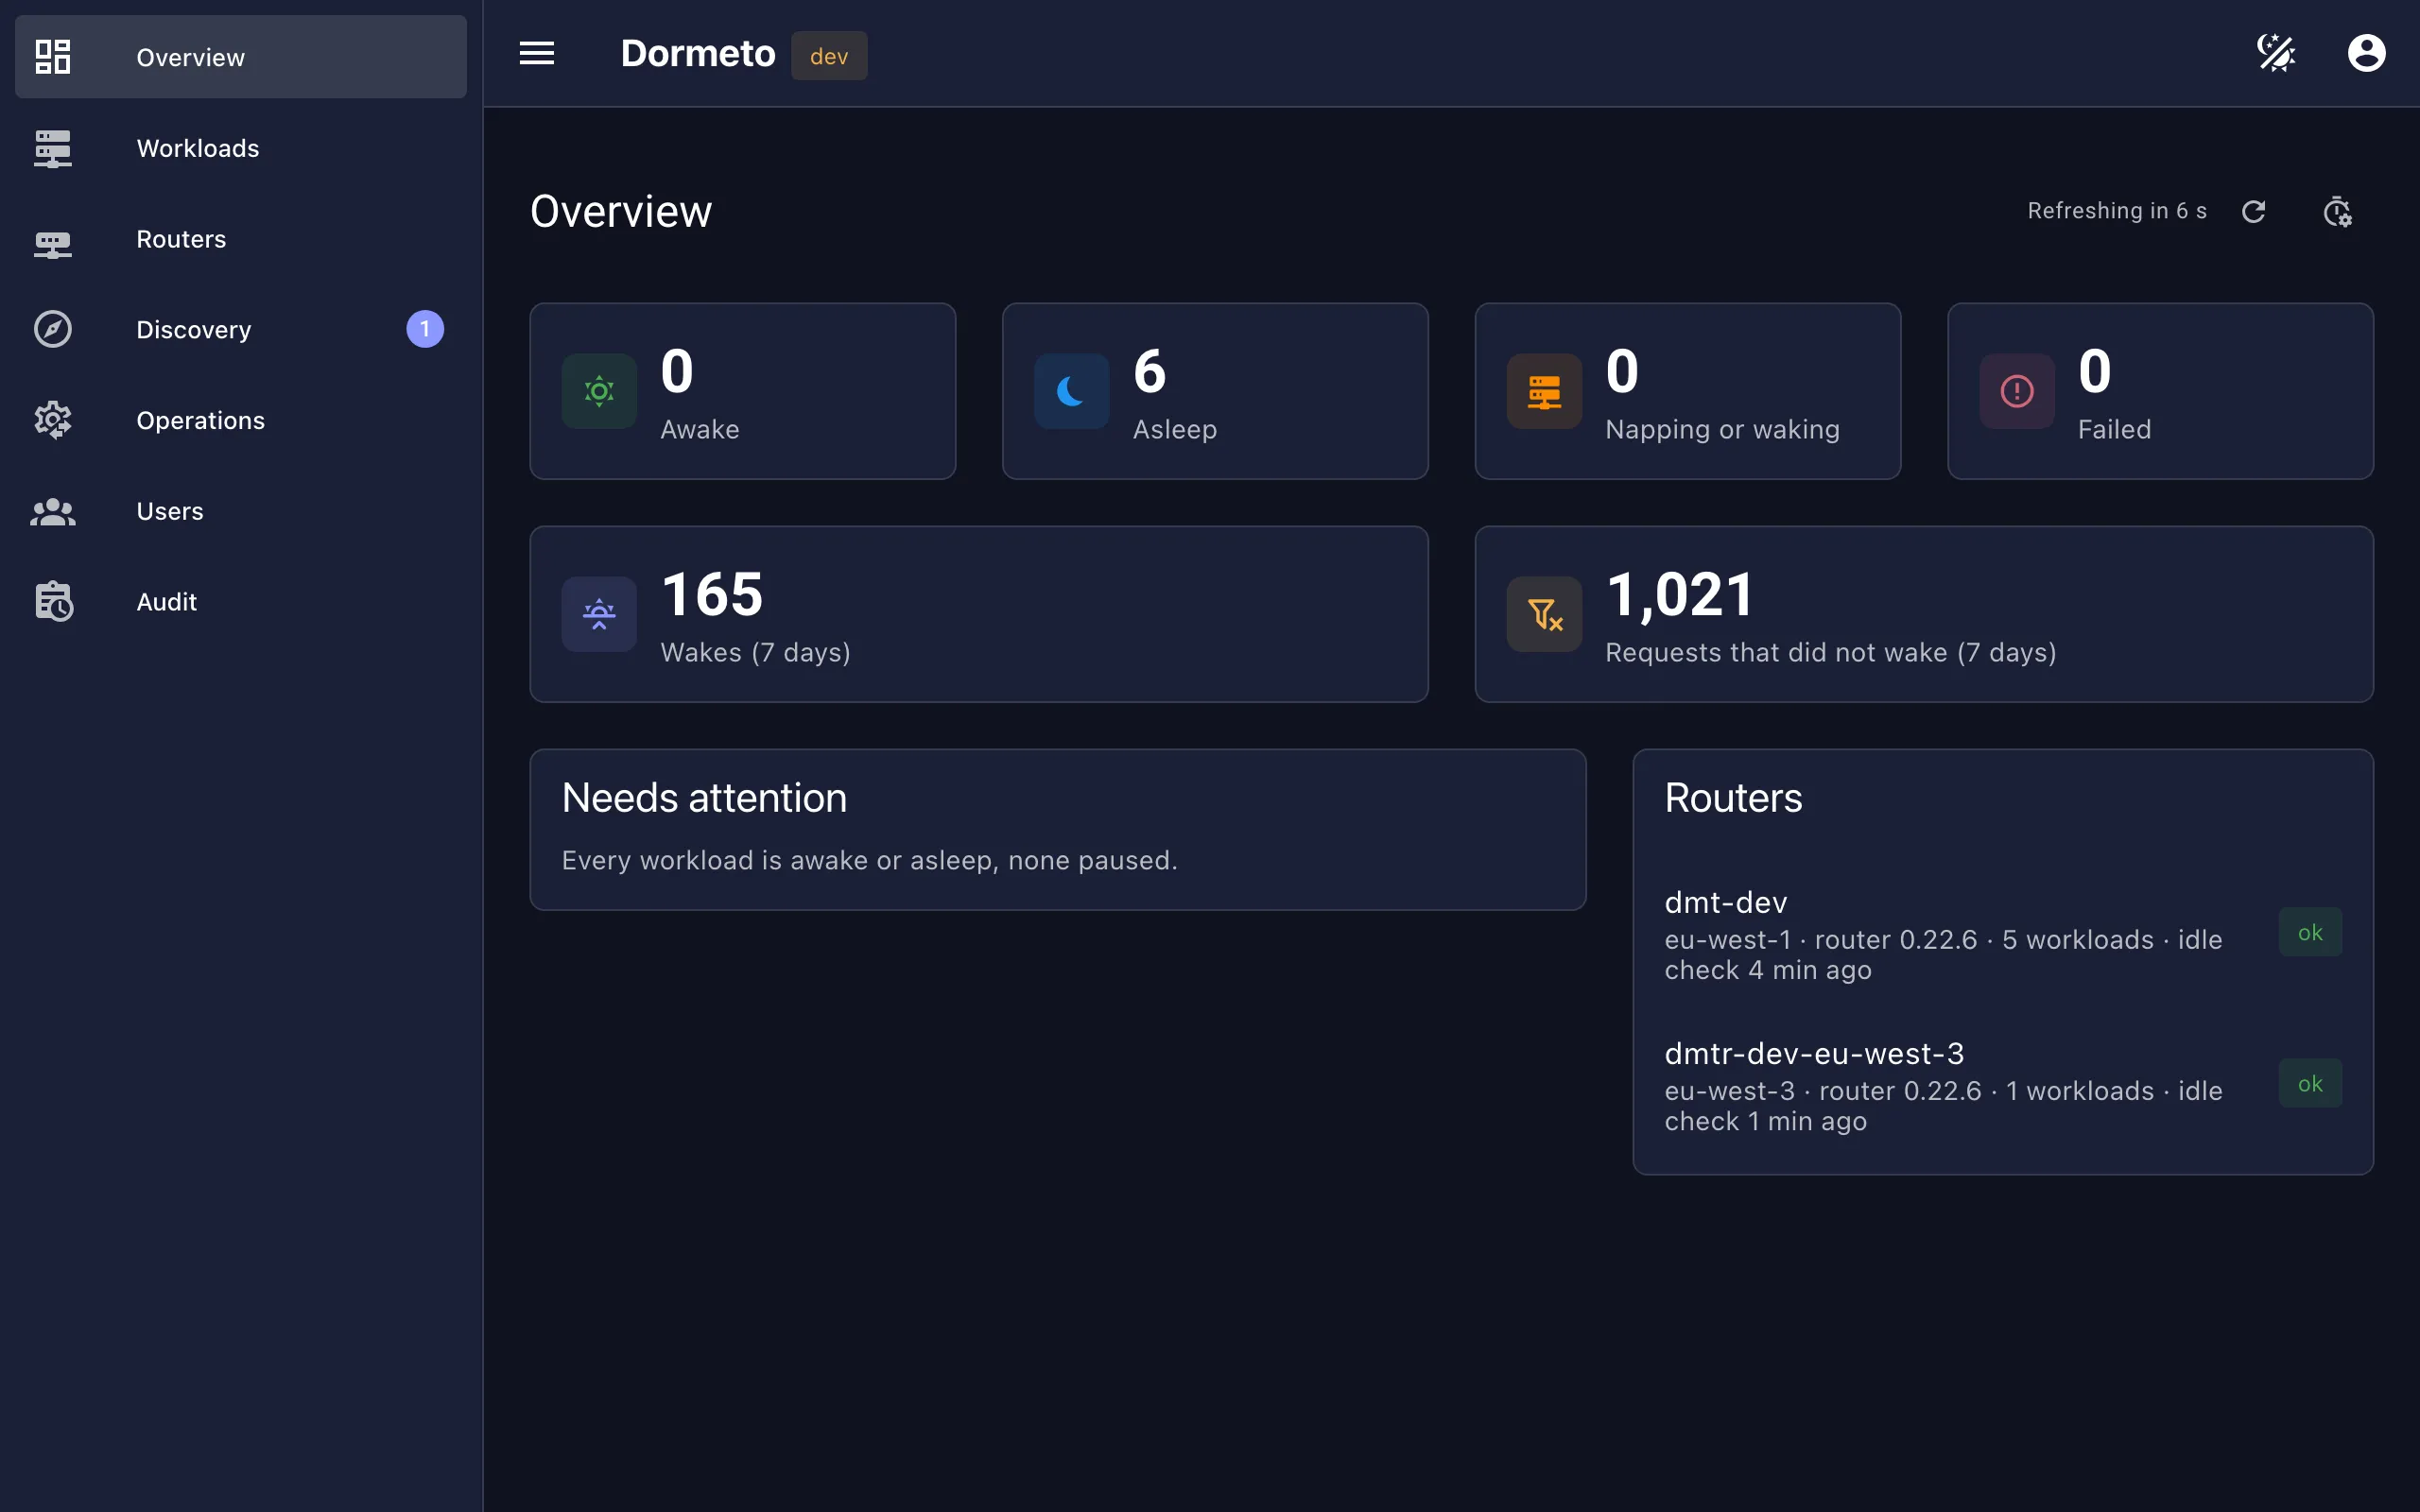
La vue d'ensemble présente les workloads par état, et les réveils et requêtes sans réveil sur 7 jours. Elle indique aussi ce qui demande votre attention et la santé de chaque routeur. Les routeurs envoient leur état au manager après chaque vérification : le tableau de bord reste rapide avec des milliers de workloads. L'historique d'un workload affiche une ligne par jour avec ses états sur 24 heures, 7 ou 30 jours. Il montre son temps passé en veille, ses réveils et leur durée. Il donne aussi l'origine de chaque changement : une requête, la vérification d'inactivité, un utilisateur du manager ou un échec. S'y ajoutent les économies estimées, par workload et sur les 30 derniers jours, déduction faite du coût de Dormeto lui-même. Elles valorisent au prix catalogue AWS ce que chaque mise en veille a arrêté (instances, tâches Fargate, bases de données), sur le temps de veille. La capacité Spot compte au prix Spot. Les remises que vous déclarez pour les Savings Plans, les Reserved Instances ou votre accord AWS s'appliquent aux prix catalogue. Enfin, la carte du délai d'inactivité rejoue les 14 derniers jours de requêtes du workload avec des délais de 5 à 120 minutes. Elle indique pour chaque délai l'économie mensuelle et la fréquence à laquelle des visiteurs réveilleraient le workload et devraient attendre. Elle donne aussi le délai à retenir.
Découverte
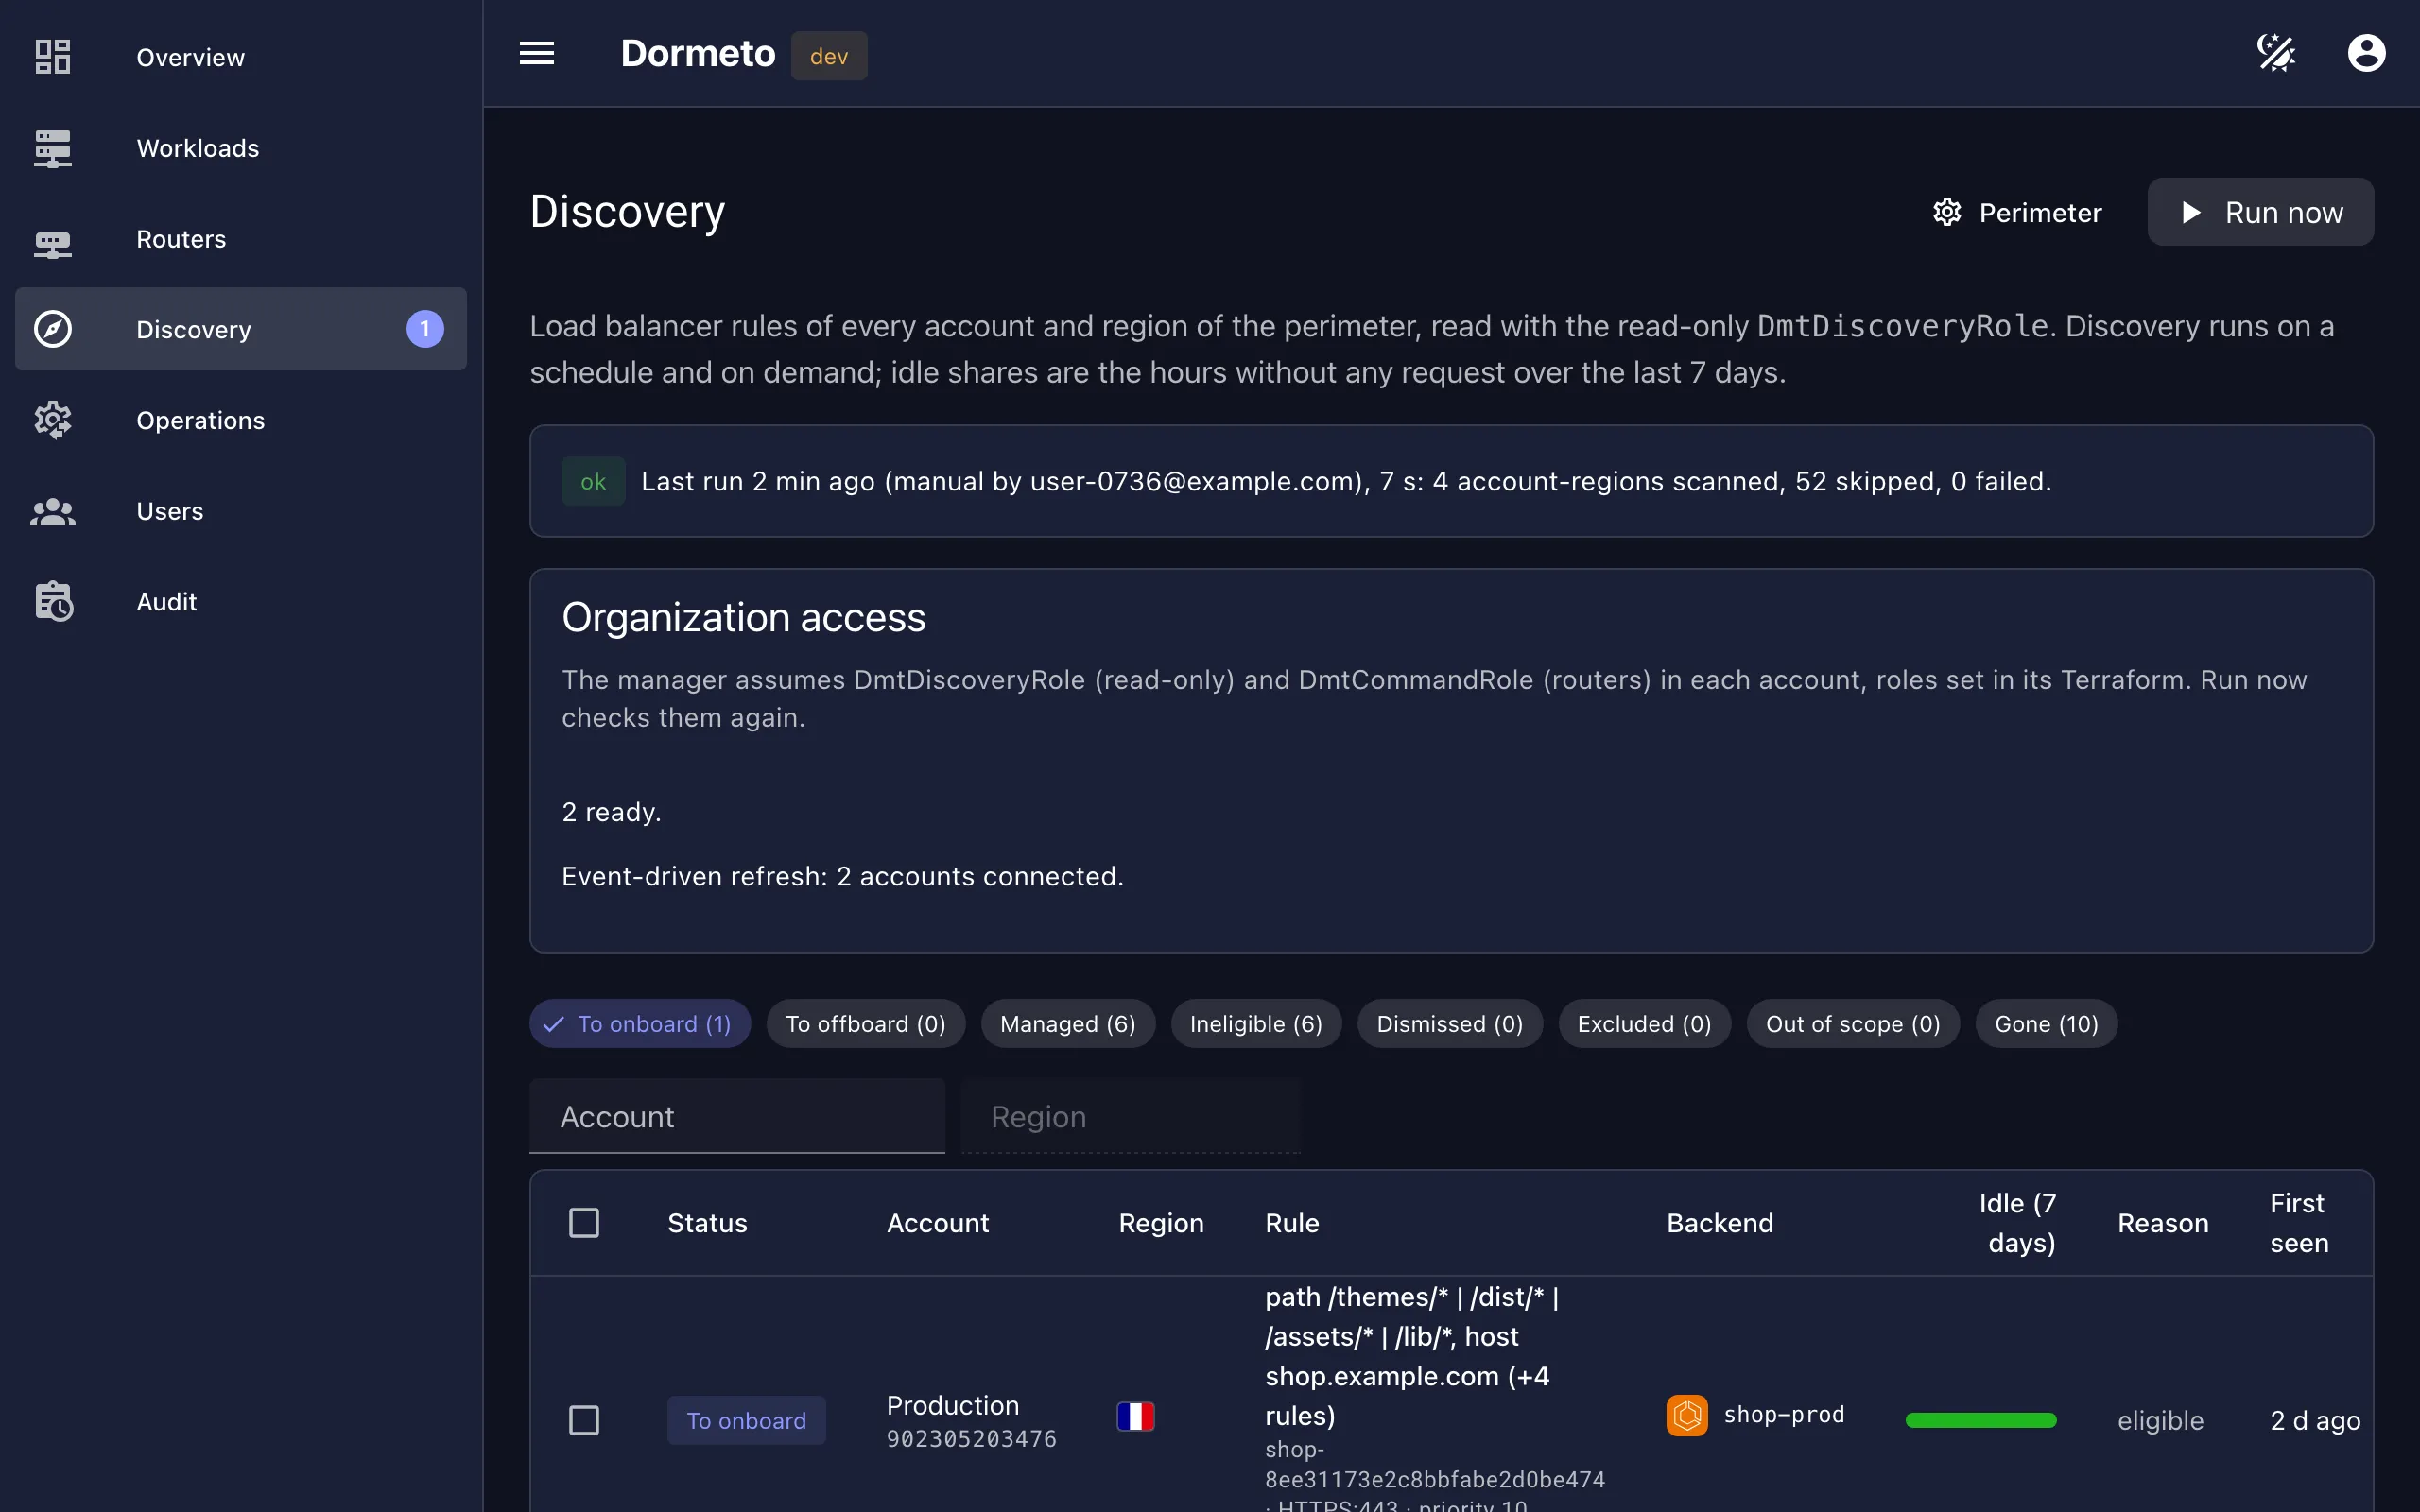
Avec un rôle en lecture seule, la découverte lit les règles des équilibreurs de charge de chaque compte et région de votre organisation. Elle affiche chaque candidat avec sa part d'inactivité sur les 7 derniers jours. Son statut : à intégrer, géré, inéligible (avec le motif), écarté, exclu ou disparu.
À chaque exécution, le panneau Organization access vérifie les rôles de chaque compte et signale ce qui manque. En savoir plus sur la découverte.
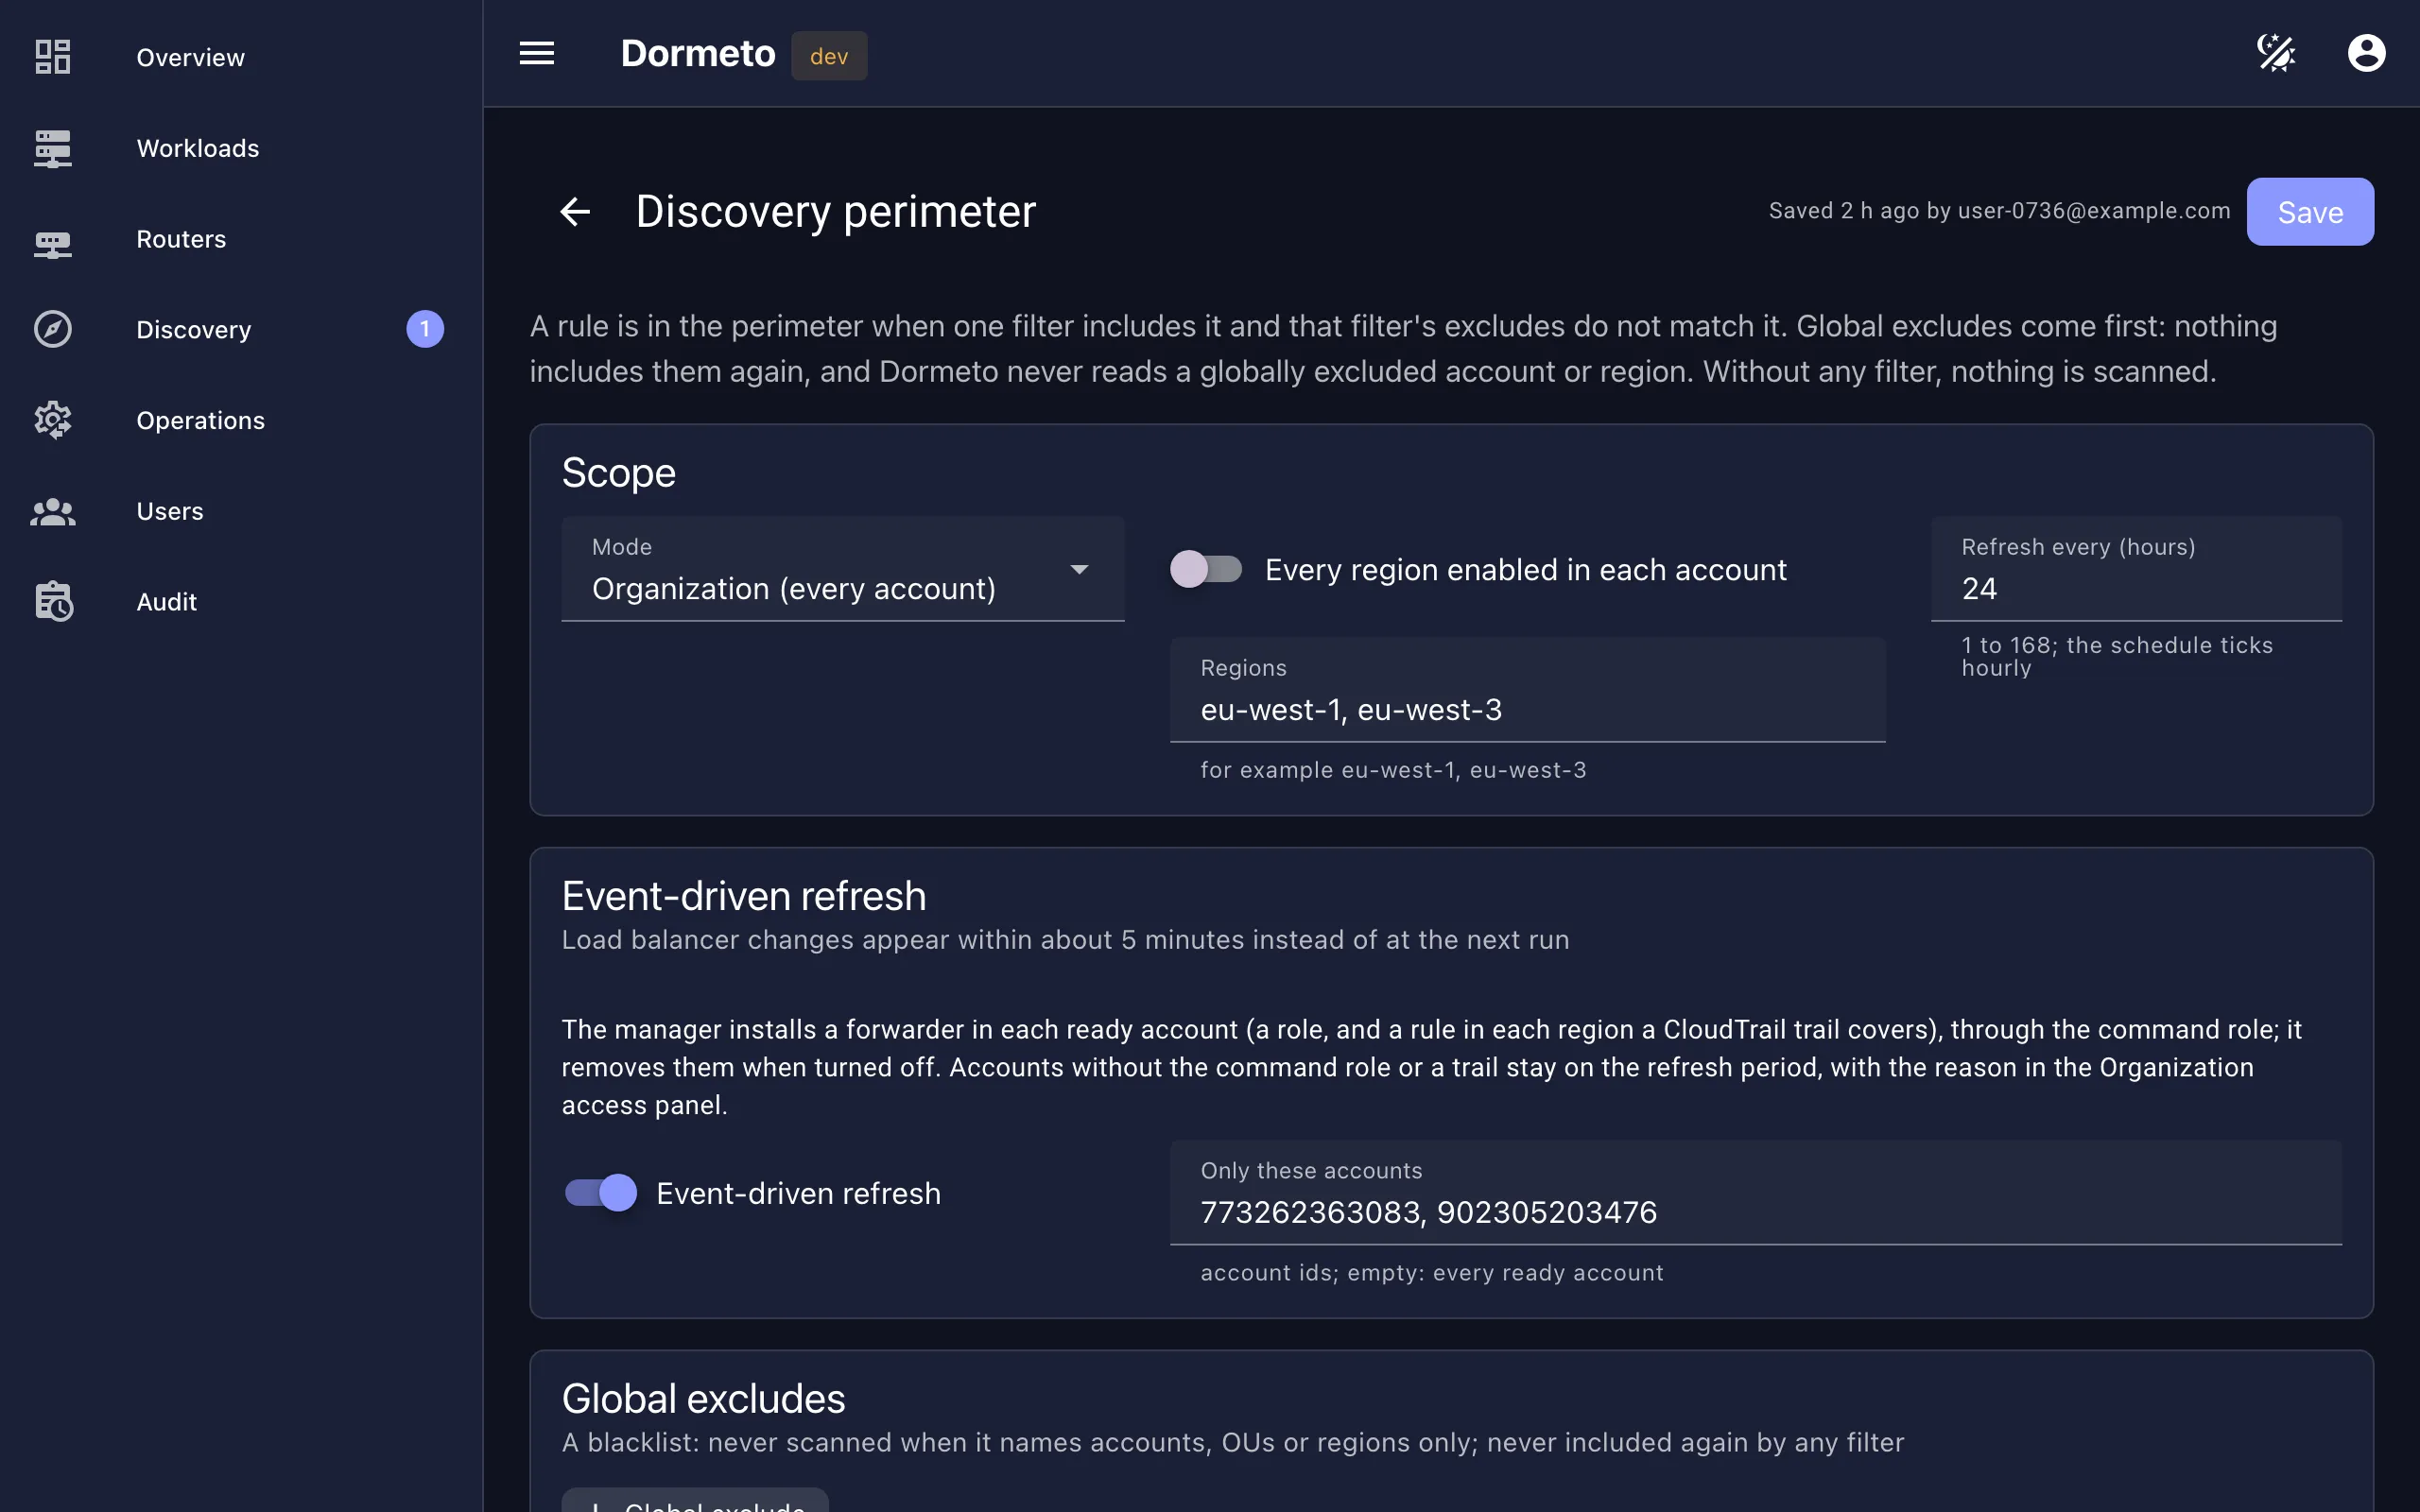
Périmètre
Intégration
L'aperçu montre ce qui changerait et vérifie les quotas de l'équilibreur de charge et de la région. S'il n'y a plus de place, il refuse en indiquant pourquoi. L'intégration tague ensuite les backends, ajoute le target group du waker et couvre chaque règle du target group. Vous choisissez le nom, le délai d'inactivité, le mode de réveil et les bases de données associées. Une intégration en échec est annulée, et le retrait n'enlève que ce que l'intégration a ajouté. En savoir plus sur les workloads.
Horaires
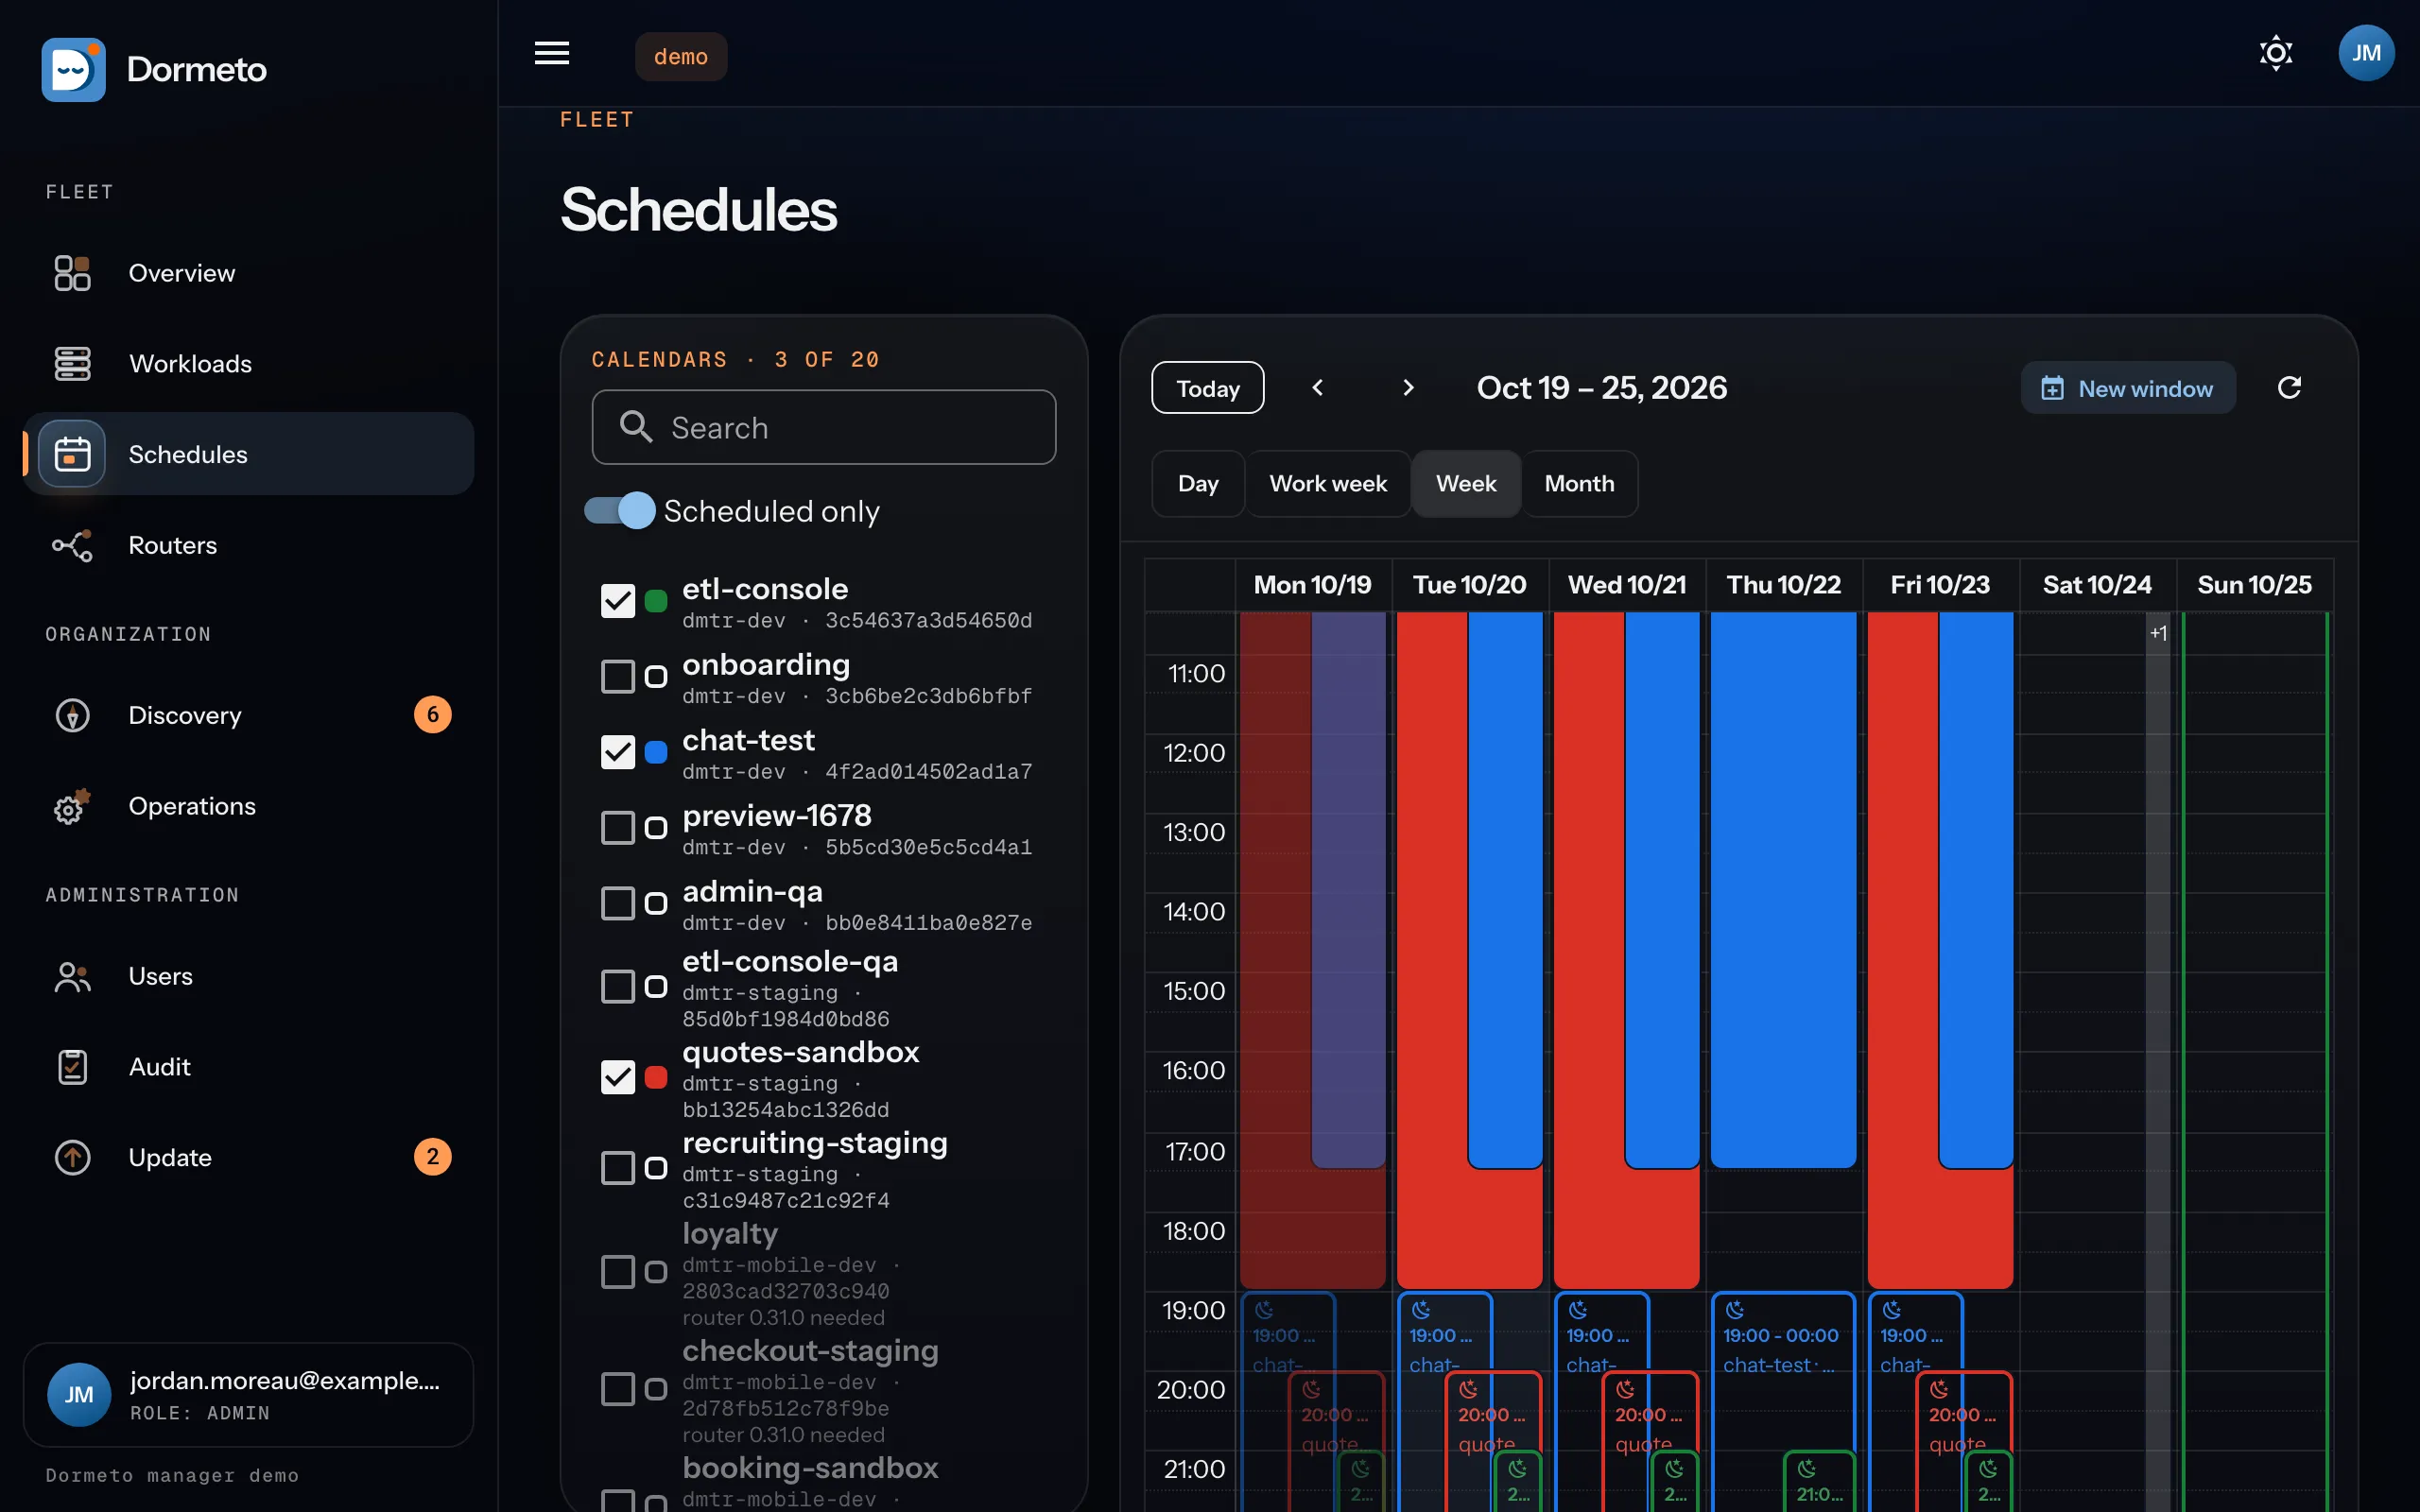
Donnez à un workload des plages hebdomadaires d'éveil et de veille, dans son fuseau. Les plages d'éveil le réveillent avant l'arrivée des équipes. Les plages de veille le gardent endormi la nuit et le week-end, quel que soit le trafic. Les jours fériés sautent les plages. Une veille maximale le réveille de temps en temps pour ses correctifs.
Le calendrier Schedules montre les plages de plusieurs workloads sur une semaine. Glissez la souris pour en ajouter une. Depuis la CI, dormeto aws workloads keep-awake garde un environnement éveillé le temps d'un job.
En savoir plus sur les horaires.
Page d'attente
Pendant le réveil, les visiteurs voient une page avec votre icône, votre titre et votre description, ou votre propre page HTML. L'icône est le favicon de l'application, trouvé pour vous, ou une image téléversée. Définissez-la pour l'organisation, un routeur ou un workload : chaque niveau remplace celui du dessus. Les visiteurs la lisent en anglais ou en français. Sa barre de progression est construite d'après les temps de réveil réels du workload. Seuls les administrateurs peuvent définir une page personnalisée, puisqu'elle s'exécute à l'adresse de l'application. Le tableau de bord prévisualise chaque état. En savoir plus sur la page d'attente.
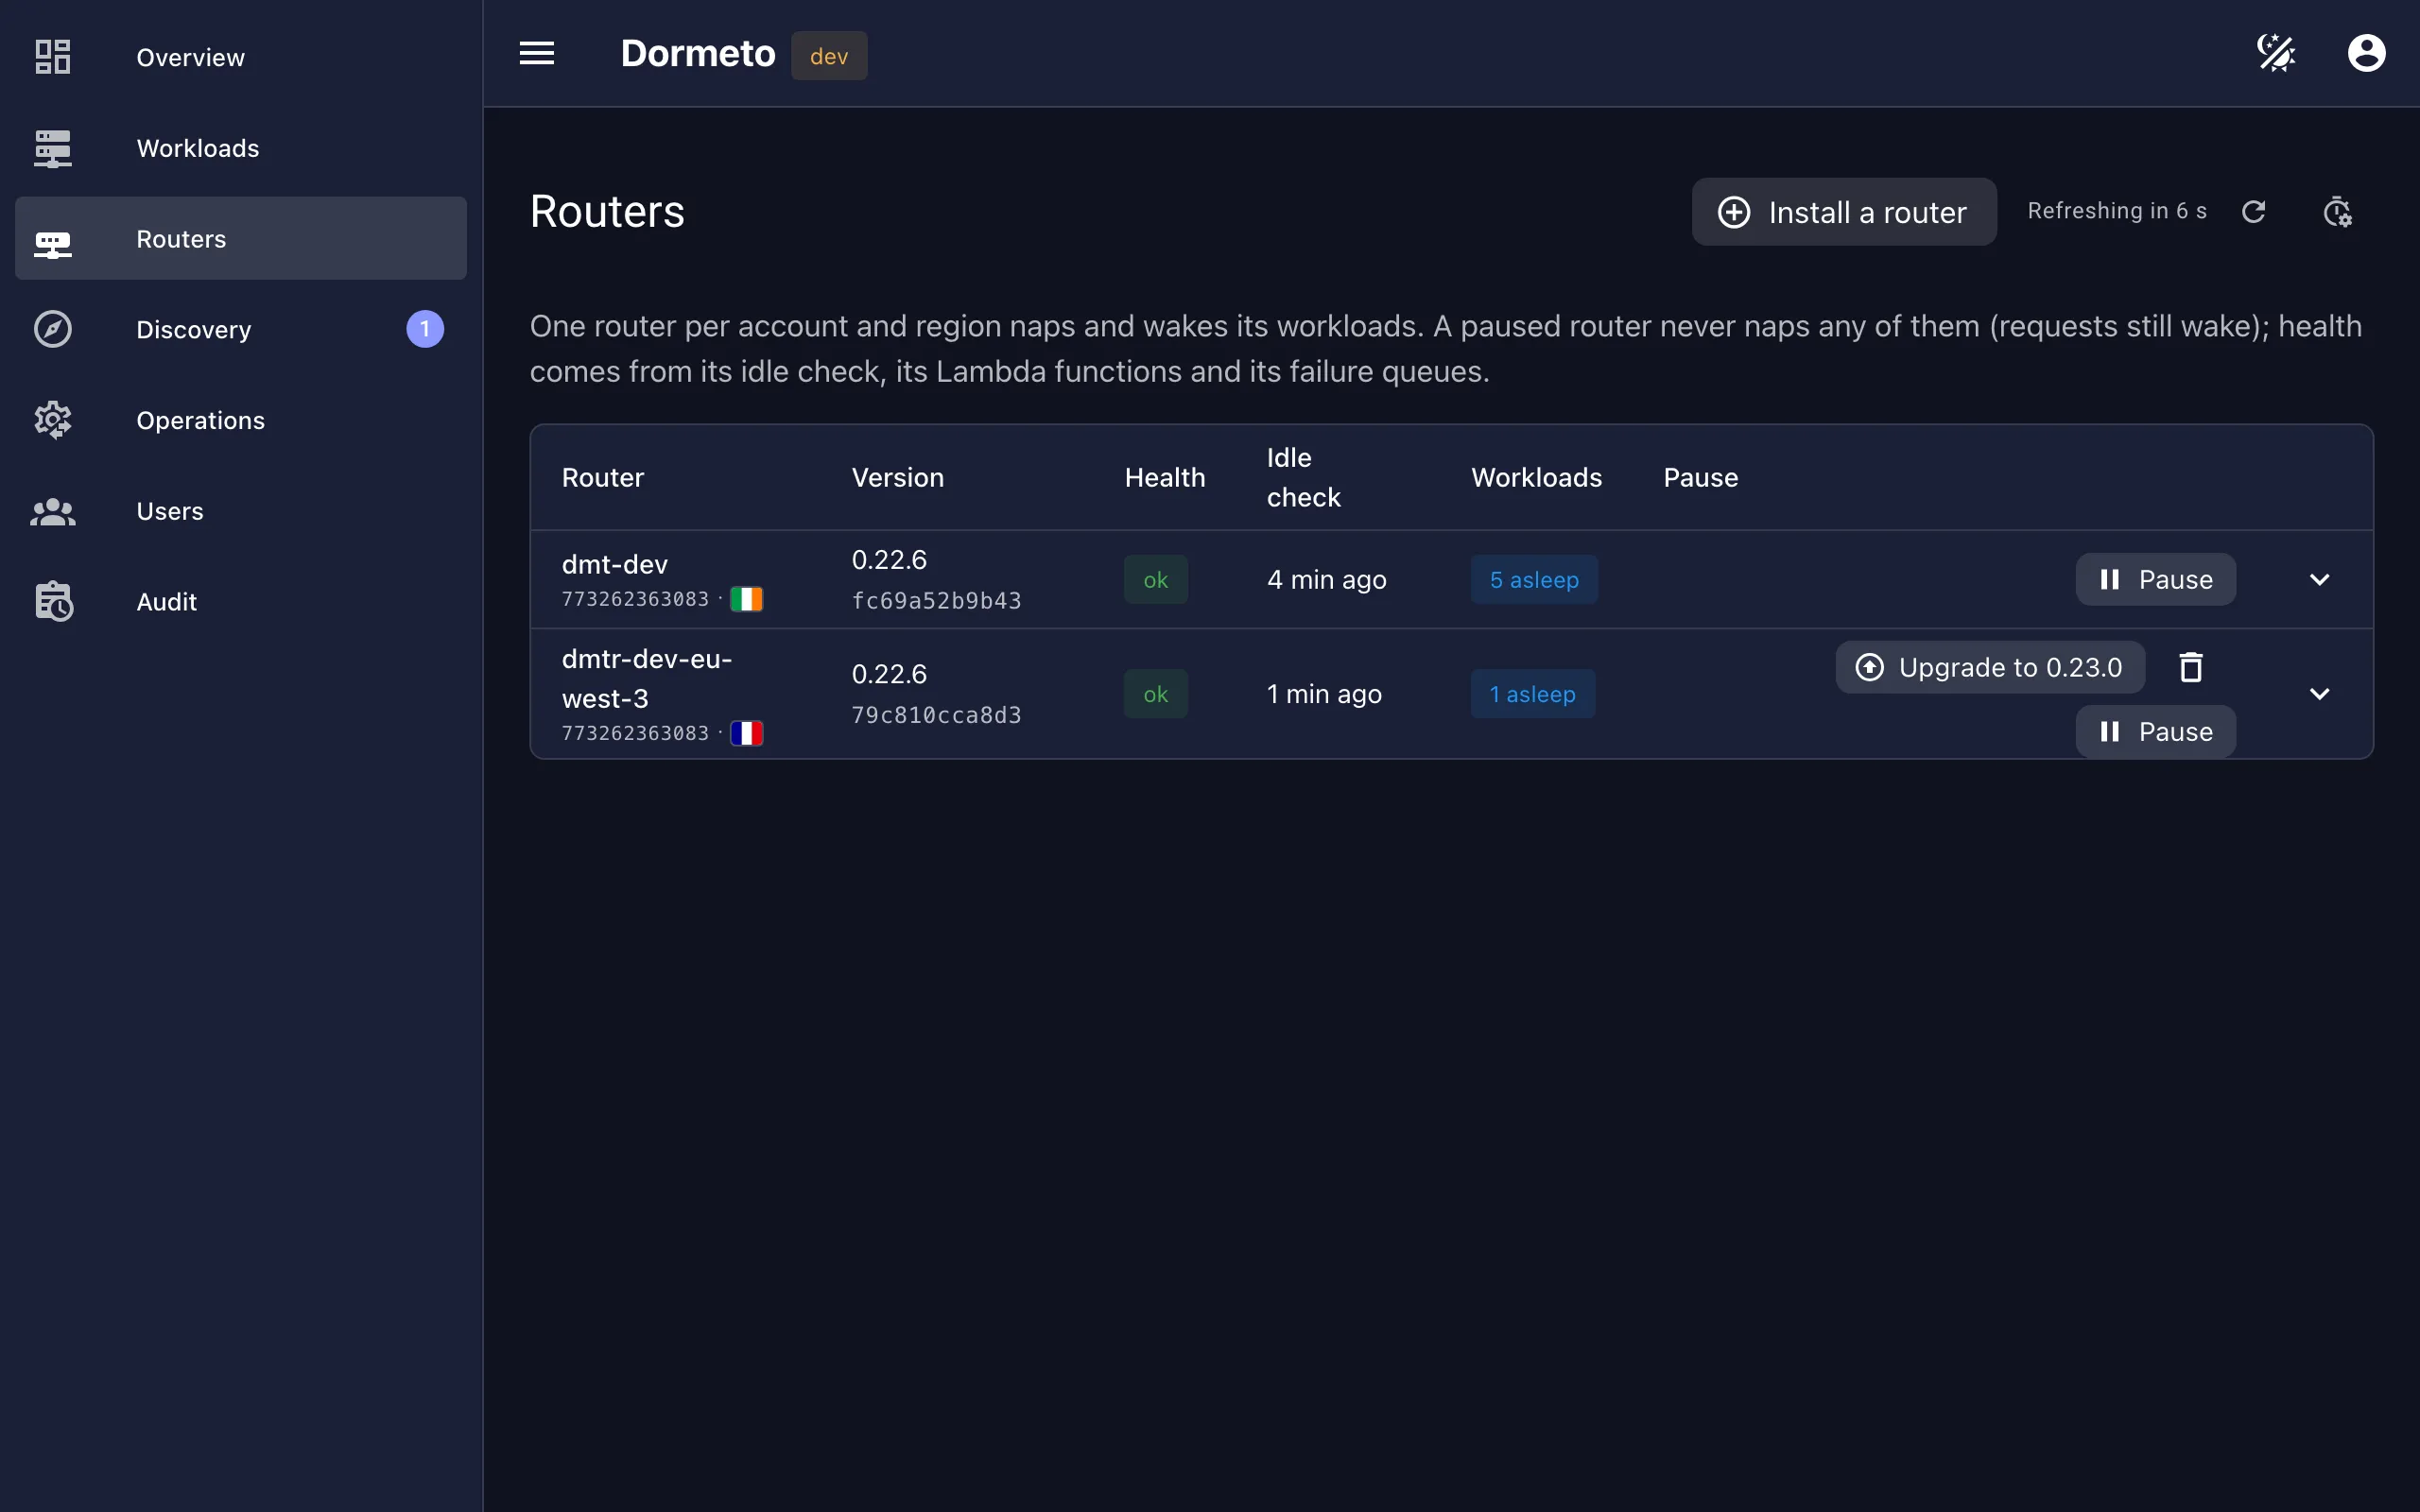
Routeurs
Le manager installe un routeur par appels d'API AWS, dans un compte et une région, avec le rôle de commande que vous avez créé. Il le met à niveau vers la version du routeur qu'il embarque. Chaque routeur remonte son état de santé : dernière vérification d'inactivité, erreurs et throttling Lambda, files d'échec. Il indique aussi la concurrence dont il pourrait avoir besoin au regard de la limite du compte. Un réveil en échec indique sa cause (capacité indisponible, quota, permission, aucune cible saine). Il est relancé avec un backoff et, si AWS manque de capacité, sur des types d'instance de repli. Il vous est signalé en moins de 5 minutes, comme les alertes de santé des routeurs. Le signalement passe par e-mail et vos canaux de chat (Amazon Q Developer dans Slack ou Microsoft Teams).
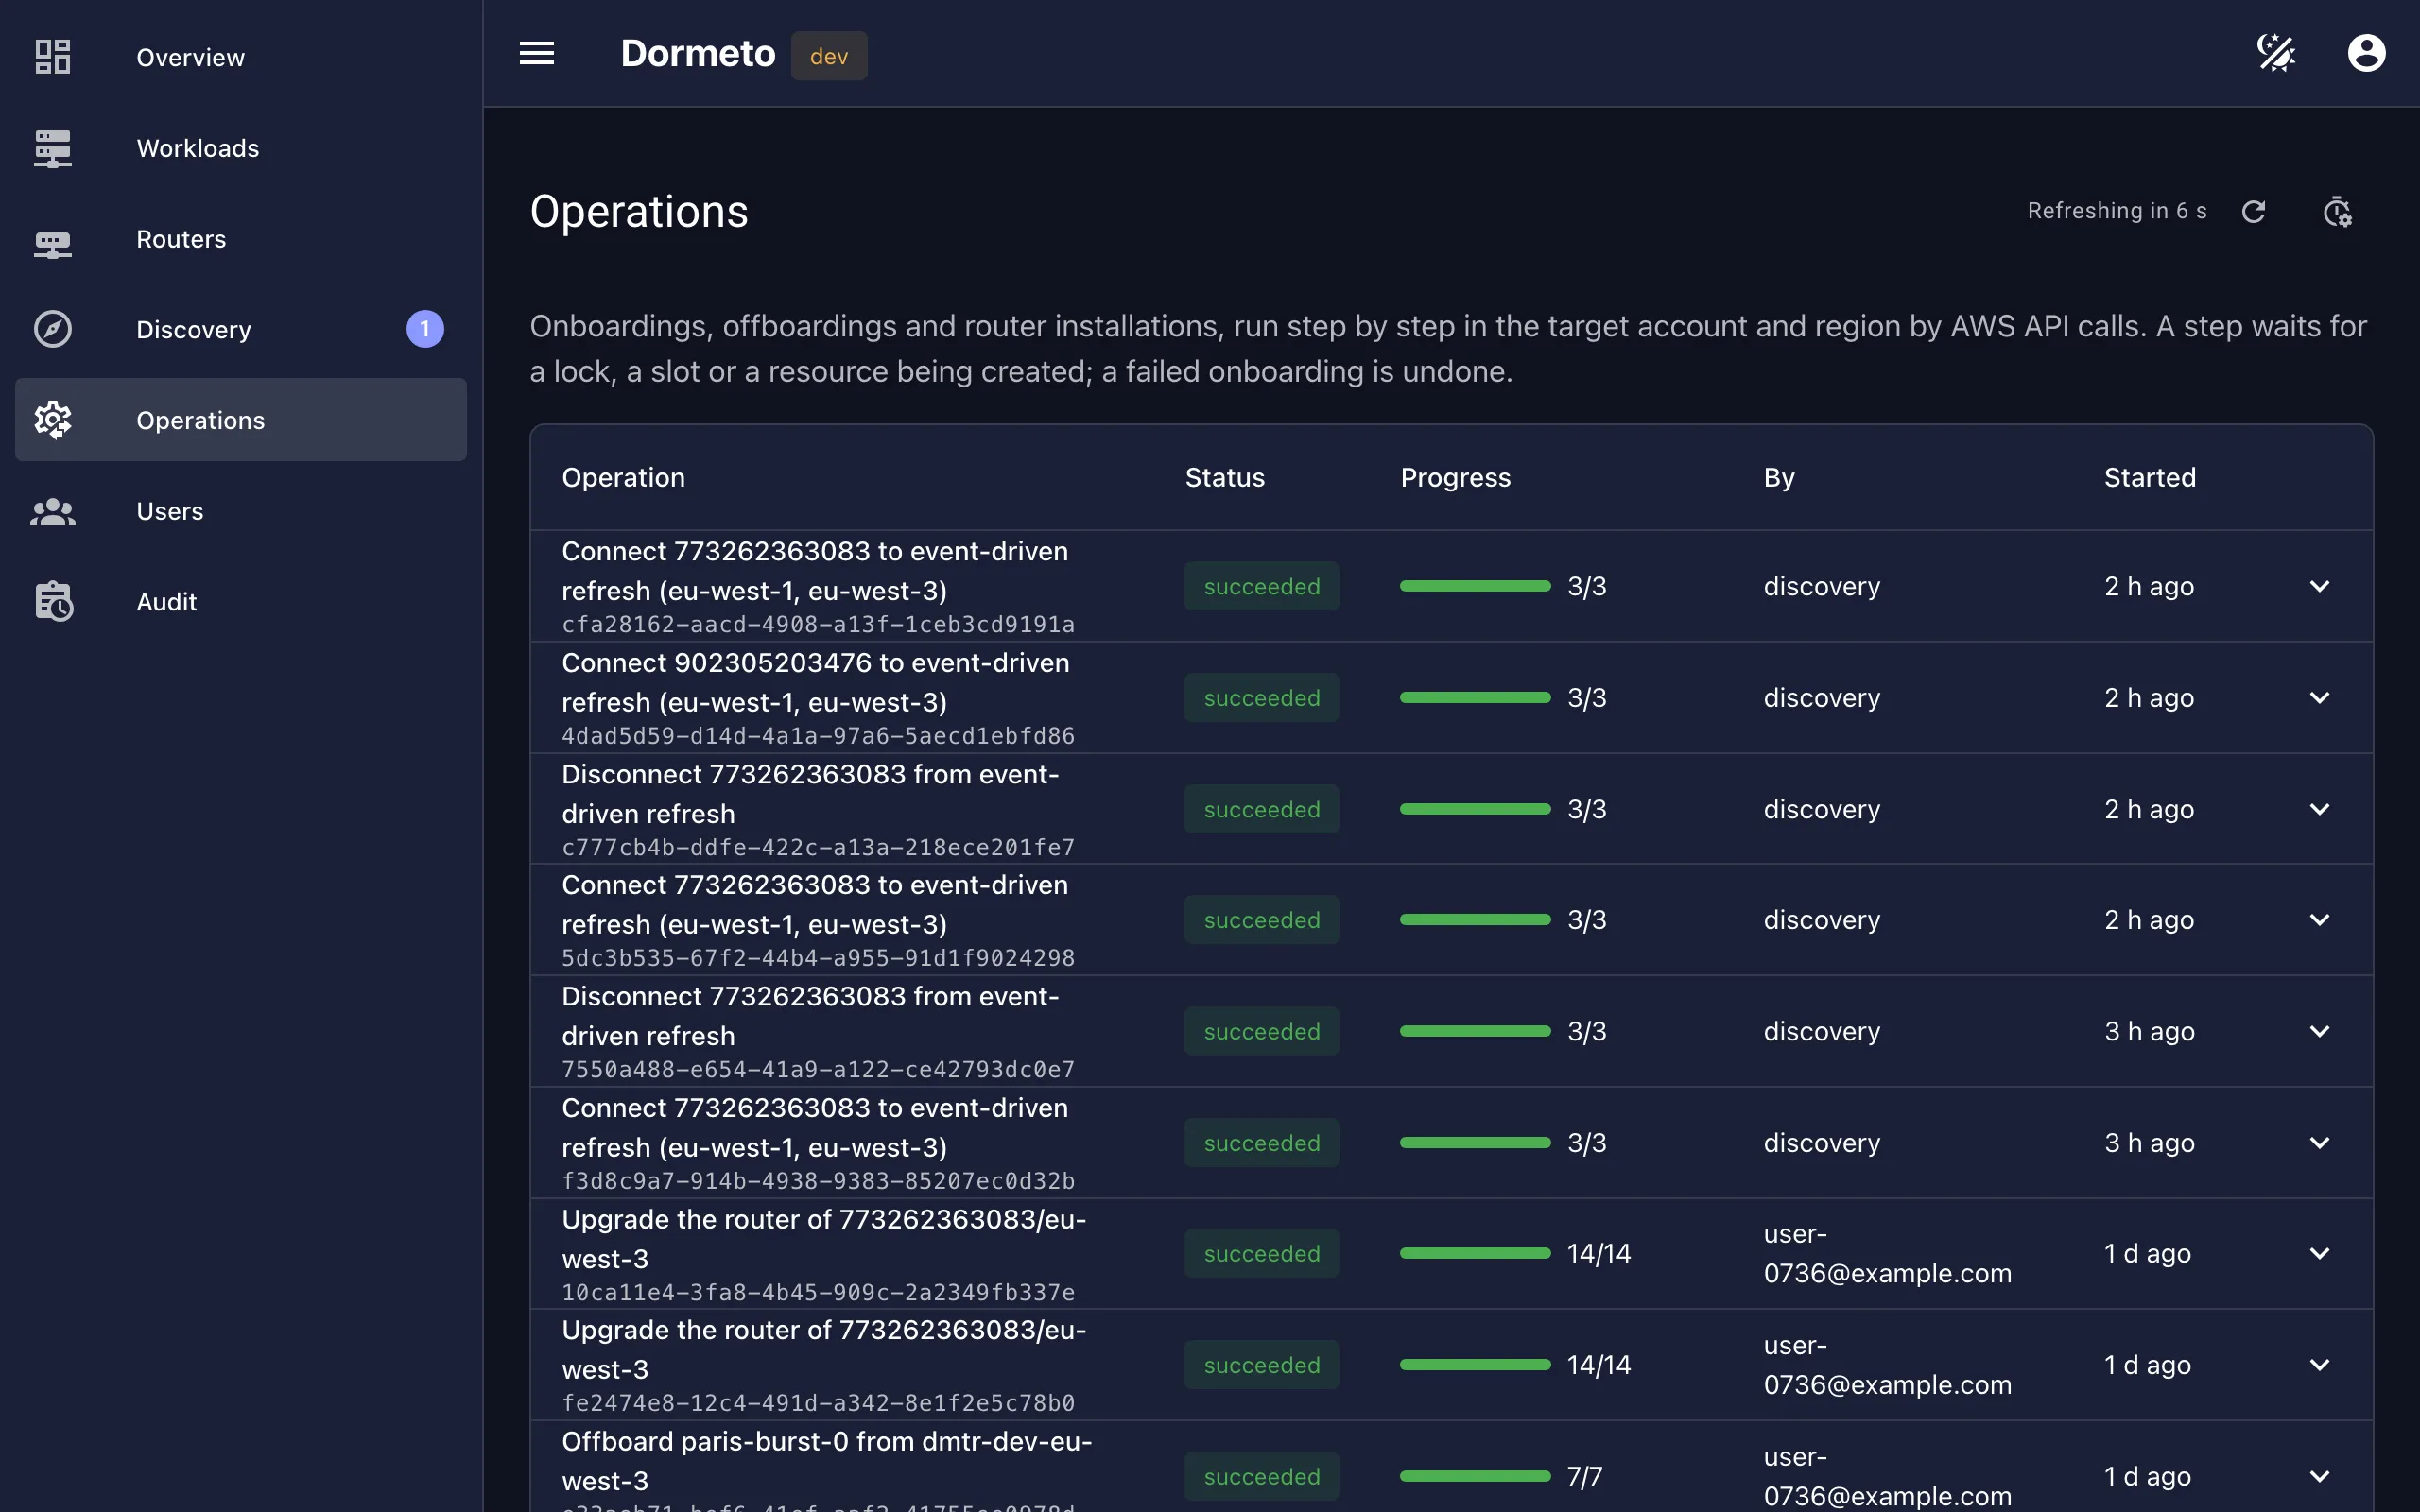
Opérations
Les intégrations, les retraits, l'installation et la mise à niveau des routeurs ainsi que les connexions de l'actualisation événementielle s'exécutent sous forme d'opérations. Chacune avance une étape à la fois, dans le compte cible. Des verrous imposent un seul changement à la fois par équilibreur de charge, et trois au plus par compte et par région. Les autres attendent leur tour.
Les lecteurs consultent. Les opérateurs mettent en veille, réveillent, intègrent et lancent la découverte. Les administrateurs installent en plus les routeurs, définissent le périmètre et gèrent les utilisateurs.
Les administrateurs invitent leurs collègues par e-mail, et la connexion passe par Amazon Cognito. Par défaut, administrateurs et opérateurs utilisent une application d'authentification, à configurer depuis le tableau de bord.
Chaque modification effectuée depuis le tableau de bord ou l'API est enregistrée avec son auteur, sa cible et son résultat.
Taguez les workloads par équipe ou application, puis donnez à des groupes la lecture, le réveil ou la mise en veille sur un tag. Chaque groupe ne voit et n'exploite que les workloads que ses tags lui donnent.
Les utilisateurs se connectent par empreinte, visage ou clé de sécurité, enregistrés depuis la page Account du tableau de bord.
Une vérification quotidienne facultative prévient les administrateurs qu'une nouvelle version du manager est disponible. Elle passe par la vue d'ensemble et le topic d'alertes.
Inscrit à la feuille de route, sans date. Dites-nous ce qui compte pour vous : contact@dormeto.com.
Règles de réveil et de non-réveil (adresses source, chemins, user agents, en-têtes). Listes de réputation IP diffusées par le manager. Réglages par défaut par type de workload. Le tout géré depuis le tableau de bord.
Réveil, mise en veille et pause depuis votre canal de chat. Un résumé périodique de ce qui a été mis en veille, des économies réalisées et des échecs.


 Amazon Cognito